가상 스크리닝
대규모 화합물 도킹으로 히트 후보 선별단백질 구조와 화합물 목록을 넣으면 화합물마다 결합 포켓에 도킹해 점수를 매깁니다. 점수, 약물 유사성, 구조 계열로 거를 수 있는 순위표를 드려, 실험 전에 무엇부터 살지 정할 수 있습니다.
GNINA 1.3.1 · CNN 재채점 · 설명서 갱신 2026. 10. 14.
- 입력
- 구조 + 화합물
- 출력
- 포즈, 점수, 클러스터
- 엔진
- GNINA
- 비용
- 화합물당 1 cr
- 실행
- GPU 최대 200대 병렬
언제 쓰나요
- 구조가 알려진 타깃에서 첫 히트 후보를 찾을 때
- 구매 가능한 라이브러리에서 무엇부터 살지 우선순위를 정할 때
- AI 코폴딩이나 활성 예측처럼 오래 걸리는 단계로 넘기기 전에 후보를 줄일 때
타깃 구조가 없으면 AI 코폴딩으로 구조부터 예측해 주세요. 도킹 점수는 실제로 측정한 결합력이 아닙니다. 화합물의 순위를 정하는 용도로 쓰고, 효능을 보장하는 값으로 쓰지 않습니다.
작동 원리
- 01수용체 준비
첫 번째 모델과 고른 체인만 남기고, 대체 원자 위치(altLoc), 물, 결합해 있던 리간드를 지웁니다. 이온과 보조인자는 선택한 것만 남깁니다.
- 02포켓 지정
구조 안의 기준 리간드나 업로드한 리간드 파일 주변으로 도킹 상자를 잡습니다. 상자의 중심과 크기를 직접 정할 수도 있습니다.
- 03도킹과 재채점
RDKit으로 화합물마다 3D 좌표를 만들고, GNINA가 상자 안에서 포즈를 찾습니다. CNN이 포즈마다 그럴듯함과 결합 세기를 다시 매깁니다.
- 04거르고 묶기
순위를 매기고 약물 유사성 물성을 계산합니다. 구조가 닮은 화합물끼리 클러스터로 묶어 계열별로 비교할 수 있습니다.
입력 형식
| 항목 | 받는 형식 | 참고 |
|---|---|---|
| 수용체 | PDB ID, 또는 50 MB 이하의 .pdb, .pdbqt, .cif 파일 | 남길 체인을 고릅니다. 물은 자동으로 지웁니다 |
| 포켓 | 기준 리간드(구조에서 고르거나 .sdf, .mol2, .pdb 파일), 또는 상자 중심과 크기 | 수동 상자는 한 변 20 Å에서 시작하고 1–100 Å로 정할 수 있습니다 |
| 화합물 | 기본 제공 라이브러리, 또는 100 MB 이하의 .smi, .txt, .csv, .tsv 파일 | 기본 제공: Enamine 세트(Hit Locator, Discovery Diversity, PPI, CNS, Covalent, 분자 접착제)와 PharmBricks. 최대 20개를 함께 고를 수 있고 중복은 지웁니다 |
| 개수 | 잡 하나에 최대 100,000개 | 회전 가능한 결합이 70개를 넘는 화합물은 차감 전에 거릅니다 |
기본 제공 라이브러리는 도킹 전에 분자량, cLogP, TPSA, 수소결합 공여체·수용체 수, QED로 좁힐 수 있습니다.
따라 하기: 알려진 EGFR 억제제를 erlotinib 포켓에 도킹
PDB 1M17은 폐암 표적인 EGFR의 키네이스 도메인에 치료제 erlotinib(리간드 코드 AQ4)이 결합한 구조입니다. erlotinib 자리를 포켓으로 삼아, 활성을 측정한 EGFR 억제제 40개를 도킹하고 강한 화합물이 위쪽에 오는지 확인해 봅니다. 페이지 위쪽의 예시로 실행을 누르면 아래 내용이 모두 채워집니다.
구조 불러오기
타깃 단백질 단계에서 PDB ID에
1M17을 입력합니다. 오른쪽 뷰어에 구조가 바로 뜹니다.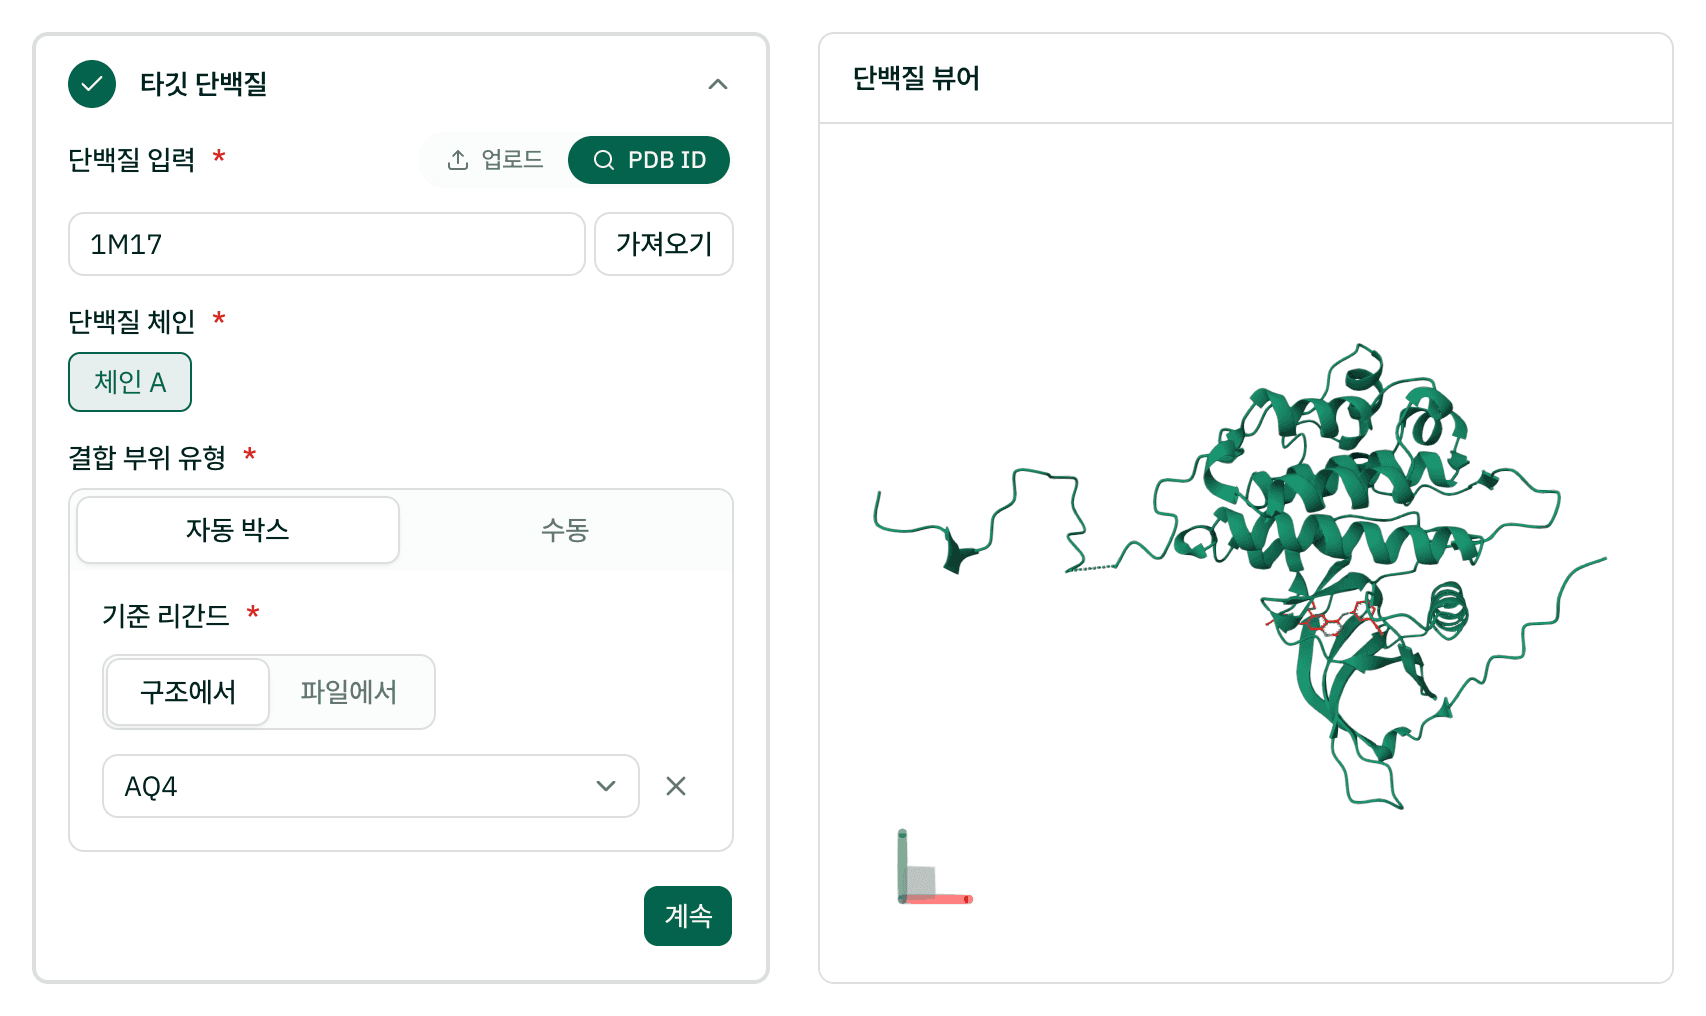
체인과 포켓 고르기
체인 A를 남기고, 결합 부위에서 자동 박스를 고른 뒤 기준 리간드로
AQ4를 선택합니다. erlotinib 주변으로 도킹 상자가 잡힙니다.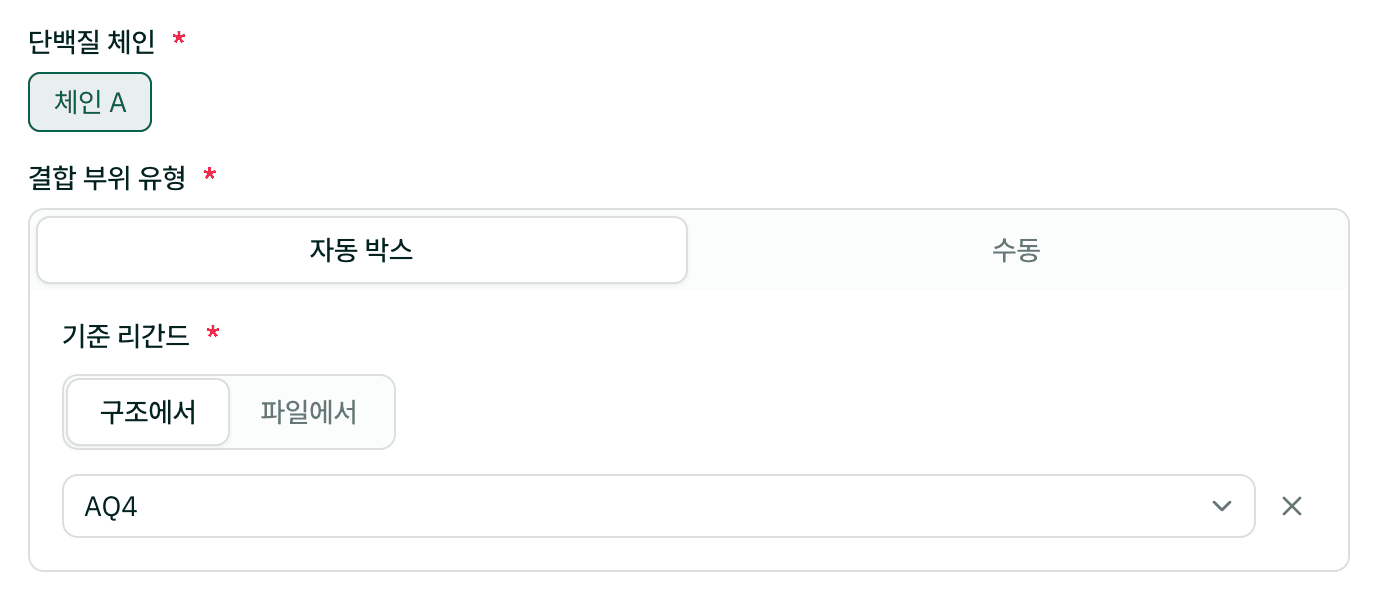
화합물 넣기
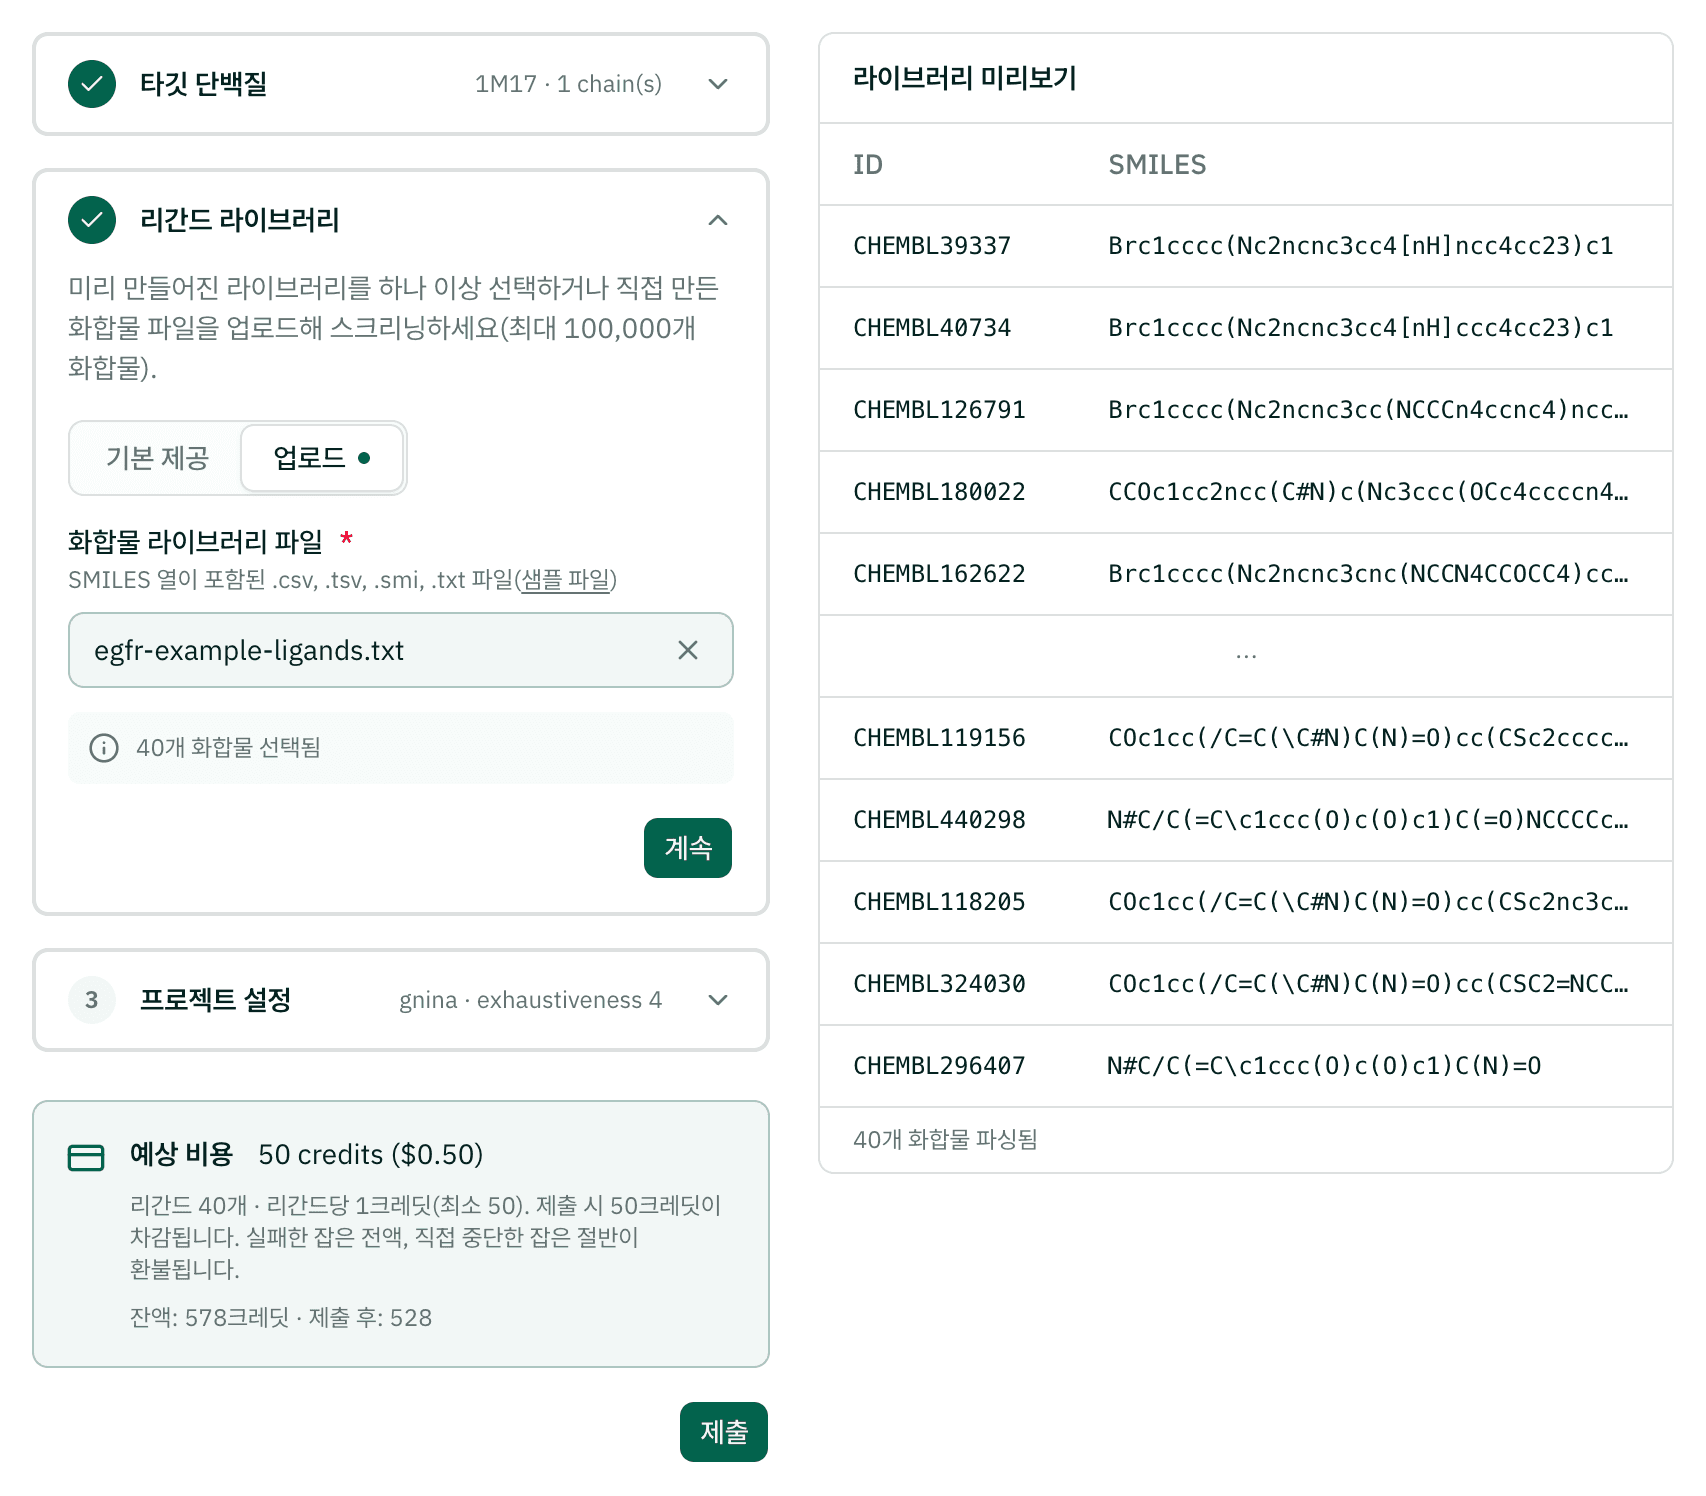
리간드 라이브러리 단계에서 업로드를 고르고 egfr-example-ligands.txt를 올립니다. ChEMBL의 EGFR 억제제 40개가 한 줄에 ID와 SMILES로 들어 있습니다. 실제 스크리닝에서는 기본 제공 라이브러리를 고르면 됩니다. 화합물 수에 맞춰 예상 크레딧이 바로 바뀝니다.
확인하고 제출
프로젝트 설정에서 이름을 정하고, 요약의 크레딧(40개는 최소 금액인 50 cr)을 확인한 뒤 제출합니다. 끝나면 메일로 알려 드립니다.
결과 거르고 묶기
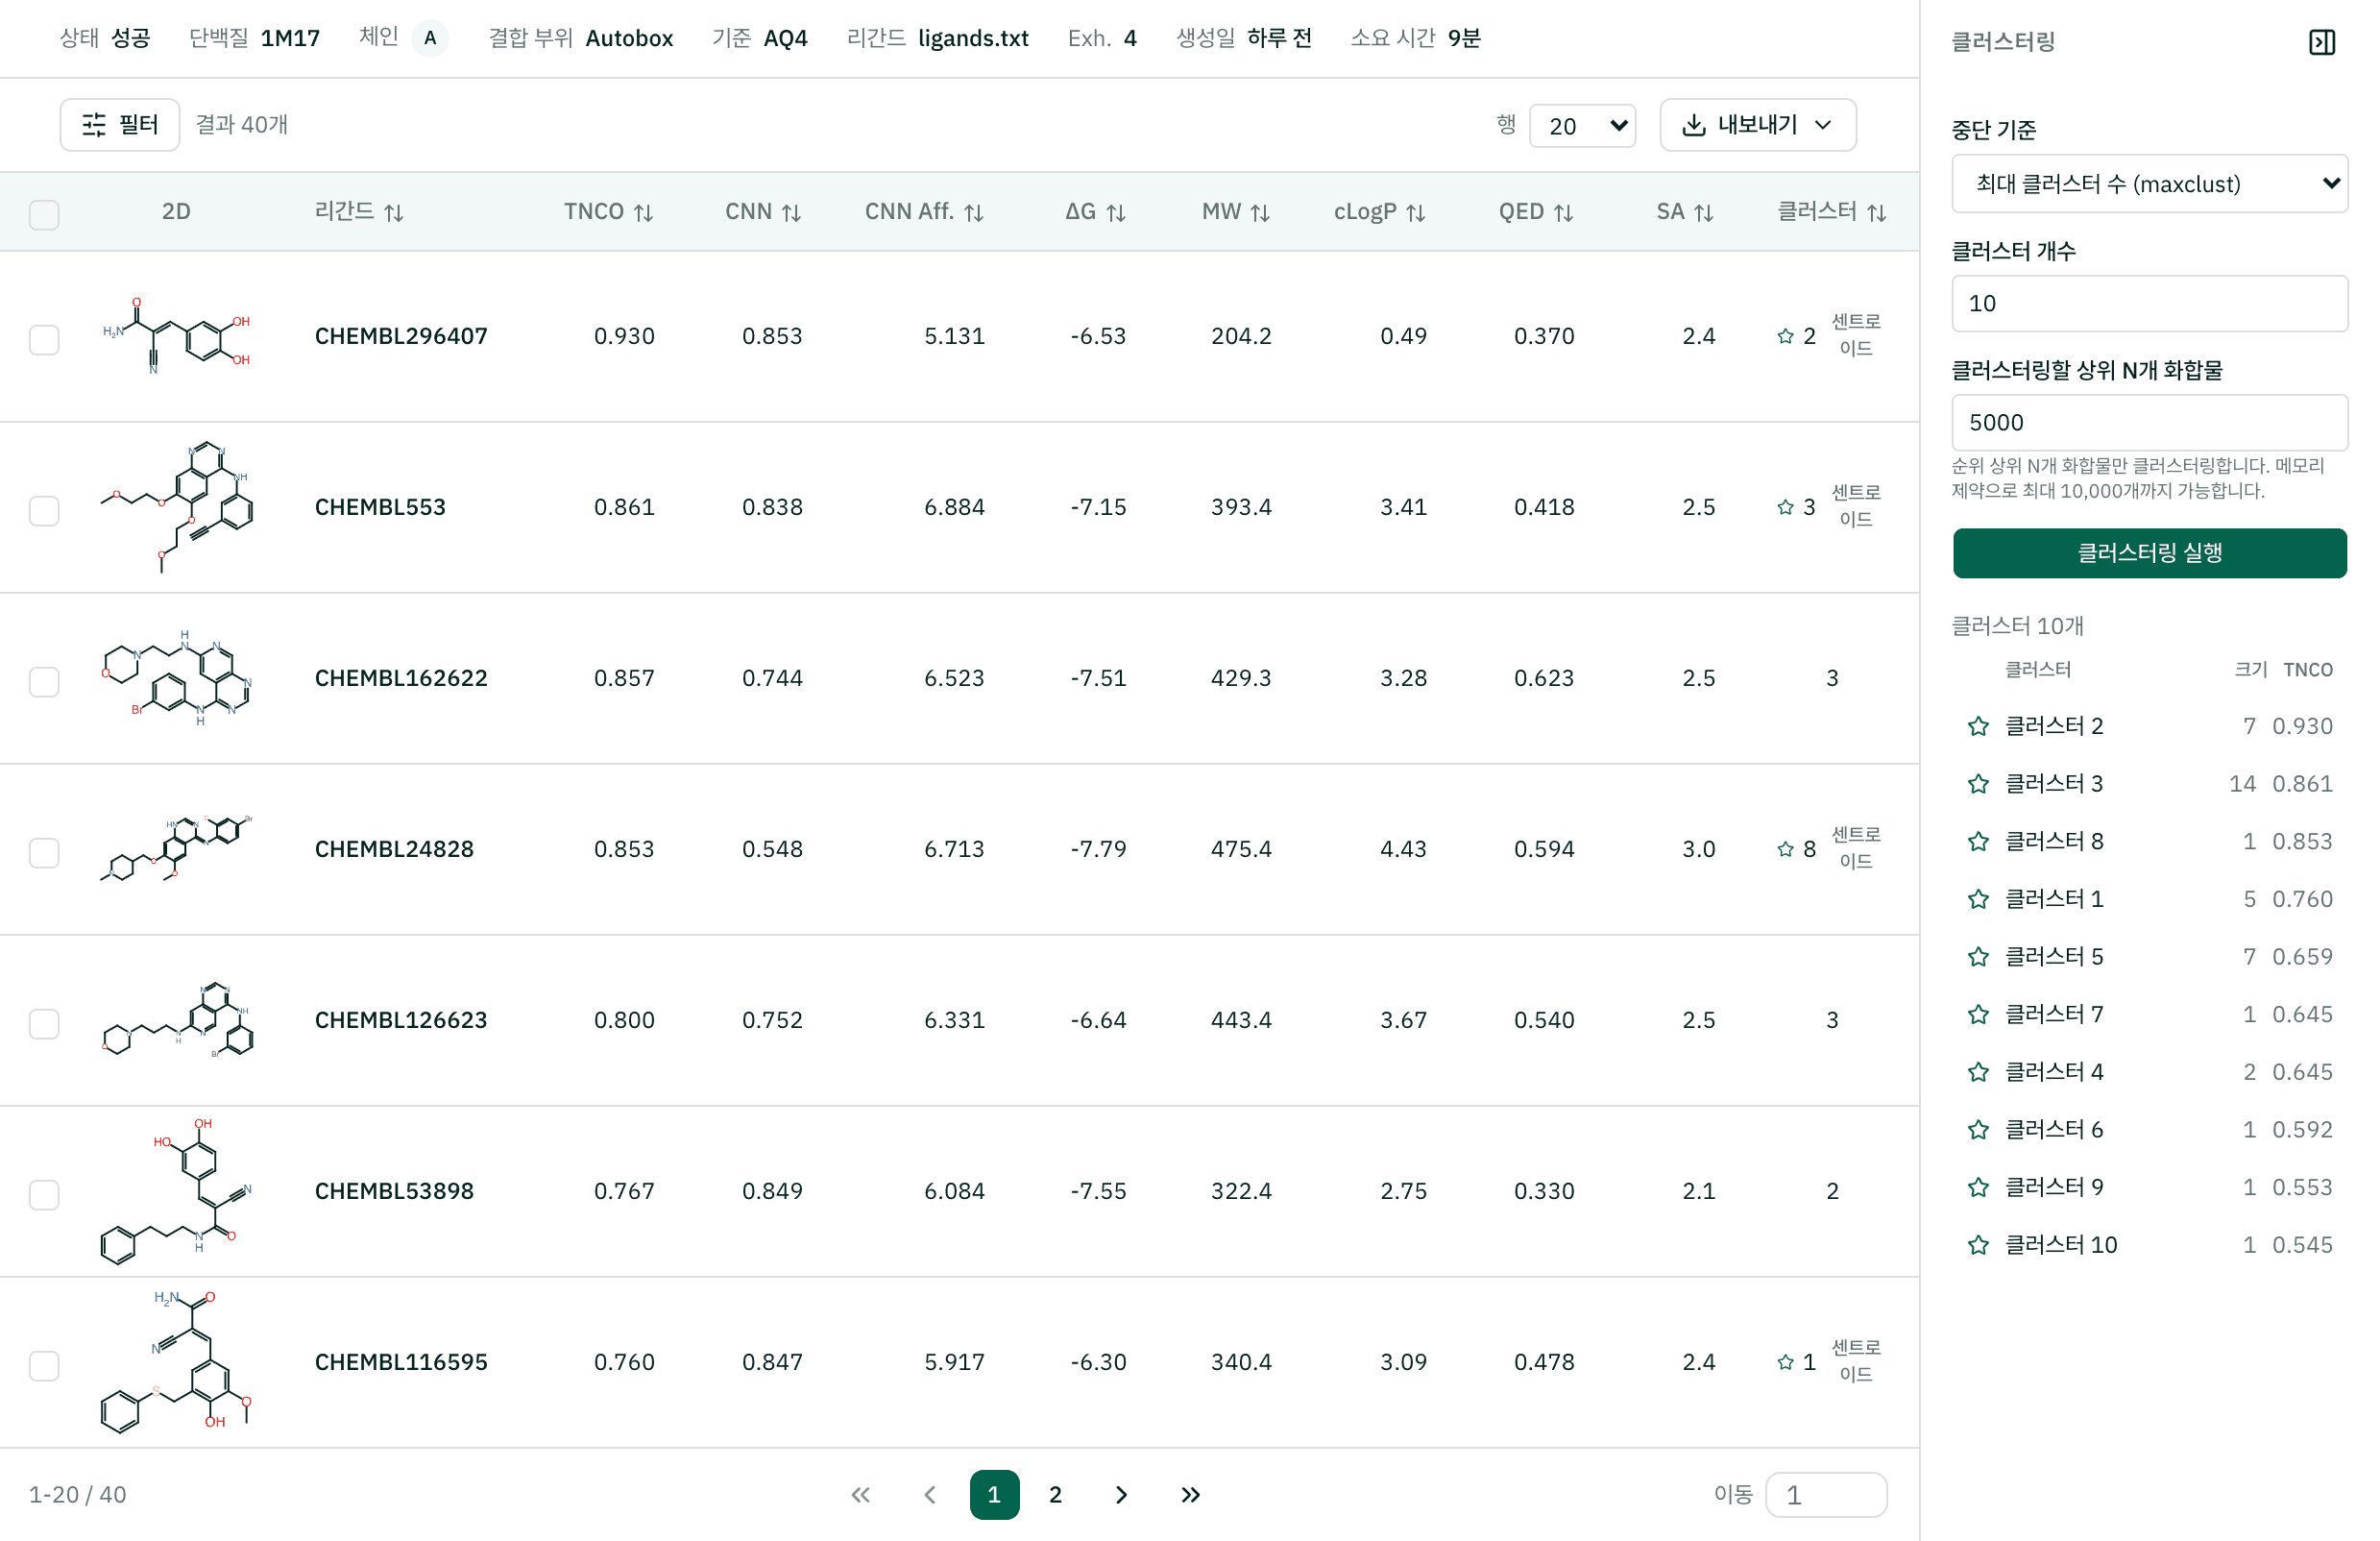
결과 화면에서 Lipinski Ro5 같은 필터 프리셋을 걸고 클러스터링을 돌린 뒤, 화합물을 열어 포즈를 3D로 확인합니다.
다음 단계로 넘기기
마음에 드는 화합물을 CSV나 SDF 포즈로 내보내거나, Enamine 화합물은 Enamine 스토어에서 열 수 있습니다. 상위 후보는 AI 코폴딩으로 결합 구조를 확인해 보세요.
결과 읽는 법
| 열 | 뜻 | 읽는 법 |
|---|---|---|
| TNCO | CNN affinity, CNN score, ΔG를 합친 점수. 화합물마다 대표 포즈를 고르고 기본 정렬에 씁니다 | 높을수록 좋습니다. 한 화합물의 포즈들 안에서 정규화한 값이라, 화합물끼리 비교할 때는 CNN Aff.와 ΔG도 함께 봅니다 |
| CNN | CNN 포즈 점수(0–1). 그 포즈가 실제 결합 자세일 가능성입니다 | 높을수록 포즈를 믿을 만합니다 |
| CNN Aff. (pKd) | CNN이 예측한 결합 세기 | 높을수록 강하게 붙는다고 예측합니다. 1 차이가 10배입니다 |
| ΔG (kcal/mol) | 물리 기반 도킹 점수 | 낮을수록(음수가 클수록) 좋습니다 |
| MW, cLogP, QED, SA | 분자량, 지용성, 약물 유사성(0–1), 합성 난이도 | 필터 프리셋(Lipinski, 리드 유사, 프래그먼트, 약물 유사)을 써 보세요 |
| Cluster | 구조가 닮은 화합물 묶음 | 계열마다 몇 개만 보면 됩니다. 클러스터에서 순위가 가장 높은 화합물이 대표입니다 |
클러스터링은 Morgan 지문(반경 2, 512비트)과 Tanimoto 유사도로 계층적 군집(average linkage)을 만들고, 기본으로 상위 5,000개를 묶습니다.
예시 결과: EGFR 1M17
실제로 돌린 잡을 읽기 전용으로 보여 드립니다. erlotinib(CHEMBL553)이 40개 중 2위에 올랐고, 뷰어에는 결정 구조에서 erlotinib이 있던 포켓에 다시 도킹된 포즈가 보입니다.
| 화합물 | TNCO | CNN | CNN Aff. | ΔG |
|---|---|---|---|---|
| CHEMBL296407 | 0.930 | 0.853 | 5.13 | -6.5 |
| CHEMBL553 (erlotinib) | 0.861 | 0.838 | 6.88 | -7.2 |
| CHEMBL162622 | 0.857 | 0.744 | 6.52 | -7.5 |
| CHEMBL24828 | 0.853 | 0.548 | 6.71 | -7.8 |
| CHEMBL126623 | 0.800 | 0.752 | 6.33 | -6.6 |
비용과 시간
| 화합물 수 | 크레딧 | 금액 |
|---|---|---|
| 1,000 | 1,000 cr | $10 |
| 10,000 | 10,000 cr | $100 |
| 100,000 | 100,000 cr | $1,000 |
화합물 1개가 1 cr($0.01)이고, 잡 하나의 최소 금액은 50 cr입니다. 화합물을 여러 묶음으로 나눠 GPU 최대 200대에서 동시에 도킹하므로, 1만 개까지는 한 번에 돌아가 수백 개일 때와 시간이 비슷합니다. EGFR 예시(40개)는 GPU가 배정된 뒤 도킹에 약 12분이 걸렸습니다. 제출 전에 크레딧을 보여 드리고, 실행 중에는 결과 화면에서 남은 시간을 보여 드립니다.
잡이 실패하거나 결과 없이 끝나면 크레딧을 모두 돌려 드립니다. 직접 중단하면 절반을 돌려 드립니다.
인용
이 워크플로우로 얻은 결과를 보고서나 논문에 쓸 때는 아래 방법론을 인용해 주세요.
- McNutt AT, Francoeur P, Aggarwal R, Masuda T, Meli R, Ragoza M, Sunseri J, Koes DR. GNINA 1.0: molecular docking with deep learning. J Cheminform 13, 43 (2021). doi:10.1186/s13321-021-00522-2도킹과 CNN 재채점
- Ragoza M, Hochuli J, Idrobo E, Sunseri J, Koes DR. Protein-ligand scoring with convolutional neural networks. J Chem Inf Model 57, 942-957 (2017). doi:10.1021/acs.jcim.6b00740CNN 점수 모델
- Trott O, Olson AJ. AutoDock Vina: improving the speed and accuracy of docking with a new scoring function, efficient optimization, and multithreading. J Comput Chem 31, 455-461 (2010). doi:10.1002/jcc.21334ΔG에 쓰는 Vina 점수 함수
- RDKit contributors. RDKit: Open-source cheminformatics. Zenodo (2026). doi:10.5281/zenodo.5916373D 좌표, 물성, 지문 계산
- Rogers D, Hahn M. Extended-connectivity fingerprints. J Chem Inf Model 50, 742-754 (2010). doi:10.1021/ci100050t클러스터링에 쓰는 Morgan(ECFP) 지문
- Stamos J, Sliwkowski MX, Eigenbrot C. Structure of the epidermal growth factor receptor kinase domain alone and in complex with a 4-anilinoquinazoline inhibitor. J Biol Chem 277, 46265-46272 (2002). doi:10.1074/jbc.M207135200따라 하기에 쓴 EGFR–erlotinib 구조(PDB 1M17)