TSAP (Boltz-2)
Boltz-2를 미세 조정한 타깃 특화 활성 예측타깃 하나에 대해 내 화합물이 얼마나 활성일지 예측합니다. 이미 타깃에 맞춰 둔 사전 학습 모델을 쓰거나, 내 활성 데이터로 직접 학습할 수 있습니다. 직접 학습하면 Boltz-2의 친화도 예측기를 내 측정값으로 미세 조정하고, 학습에 쓰지 않은 화합물로 검증한 뒤 새 화합물을 예측합니다.
Boltz-2 미세 조정 (TSAP 파이프라인 v2.2) · 설명서 갱신 2026. 10. 14.
- 입력
- 타깃 + 활성 데이터, 또는 사전 학습 모델
- 출력
- 예측 활성, 모델 품질
- 엔진
- Boltz-2
- 비용
- 100 cr부터, 제출 전 견적
- Standard 프리셋
- 약 1시간
언제 쓰나요
- 타깃 하나에 대해 30개 이상 화합물의 측정 활성(IC50, Ki, Kd, EC50)이 있고, 새 아이디어의 순위를 매기고 싶을 때
- 타깃이 사전 학습 모델 목록에 있어, 내 데이터 없이 빠르게 예측하고 싶을 때
- 일반 도킹이나 코폴딩 점수로는 활성 화합물이 잘 갈리지 않을 때
모델은 학습한 데이터만큼만 정확합니다. 학습 화합물과 많이 다른 화합물은 예측을 덜 믿어야 합니다. 순위를 믿기 전에 학습에 쓰지 않은 화합물로 잰 모델 품질부터 확인해 주세요.
작동 원리
- 01화합물 배치
Boltz-2가 화합물마다 타깃과의 구조를 만들고, 기준 리간드의 결합 부위에 앉은 포즈만 남깁니다(접촉 잔기 겹침, High Accuracy는 공통 골격 RMSD).
- 02데이터 나누기
통과한 화합물을 활성 범위에 고르게 퍼지도록 학습용과 20% 검증용으로 나눕니다. 검증용은 학습에 쓰지 않습니다.
- 03미세 조정
Boltz-2의 친화도 예측 부분만 사전 학습 가중치에서 출발해 학습시켜, 타깃의 활성 척도를 익히게 합니다. 가장 좋은 epoch를 남기고, 사전 학습 모델보다 나아지지 않으면 크레딧을 돌려 드립니다.
- 04검증과 예측
조정한 모델로 검증 화합물을 예측해 정확도를 보고하고, 제출한 새 화합물을 예측합니다.
입력 형식
| 항목 | 받는 형식 | 참고 |
|---|---|---|
| 모델 | 사전 학습 모델, 또는 새로 학습 | 사전 학습 모델은 자체 설정과 기준 구조를 씁니다 |
| 타깃(학습) | 체인 1–10개: 서열, 4자리 PDB ID, .pdb/.cif 업로드 | 구조에서는 학습할 체인을 고릅니다. 기본은 가장 긴 체인입니다. 체인마다 MSA, 템플릿, 고리형은 선택입니다 |
| 결합 부위 기준(학습) | 리간드가 결합한 구조: .cif, .pdb, .sdf, .mol, .mol2 | 새 화합물도 예측하면 꼭 필요합니다. 물, 이온, GOL 같은 첨가제는 리간드로 고를 수 없습니다 |
| 활성 데이터(학습) | 헤더가 있는 .txt, .csv, .tsv: SMILES, 활성값, ID(선택) | 화합물 30개 이상. 잡 하나에 단위 하나(M부터 fM까지, 또는 이미 p 척도인 값) |
| 예측할 화합물 | .txt, .smi, .csv, 한 줄에 하나: SMILES, 또는 ID 탭 SMILES | 사전 학습 모델이면 1개 이상 필요, 학습할 때는 선택 |
활성값은 p 척도로 바꿉니다. pX는 몰 농도의 −log10이라, 1 nM은 9가 됩니다.
따라 하기: 사전 학습 모델로 EGFR 활성 예측
Virtual Screening과 AI 코폴딩 설명서에서 다룬 폐암 표적 EGFR은 PDB 1M17을 기준 구조로 쓰는 사전 학습 TSAP 모델이 목록에 있어, 점수를 매길 화합물만 있으면 됩니다. 페이지 위쪽의 예시로 실행을 누르면 아래 내용이 모두 채워집니다.
모델 고르기
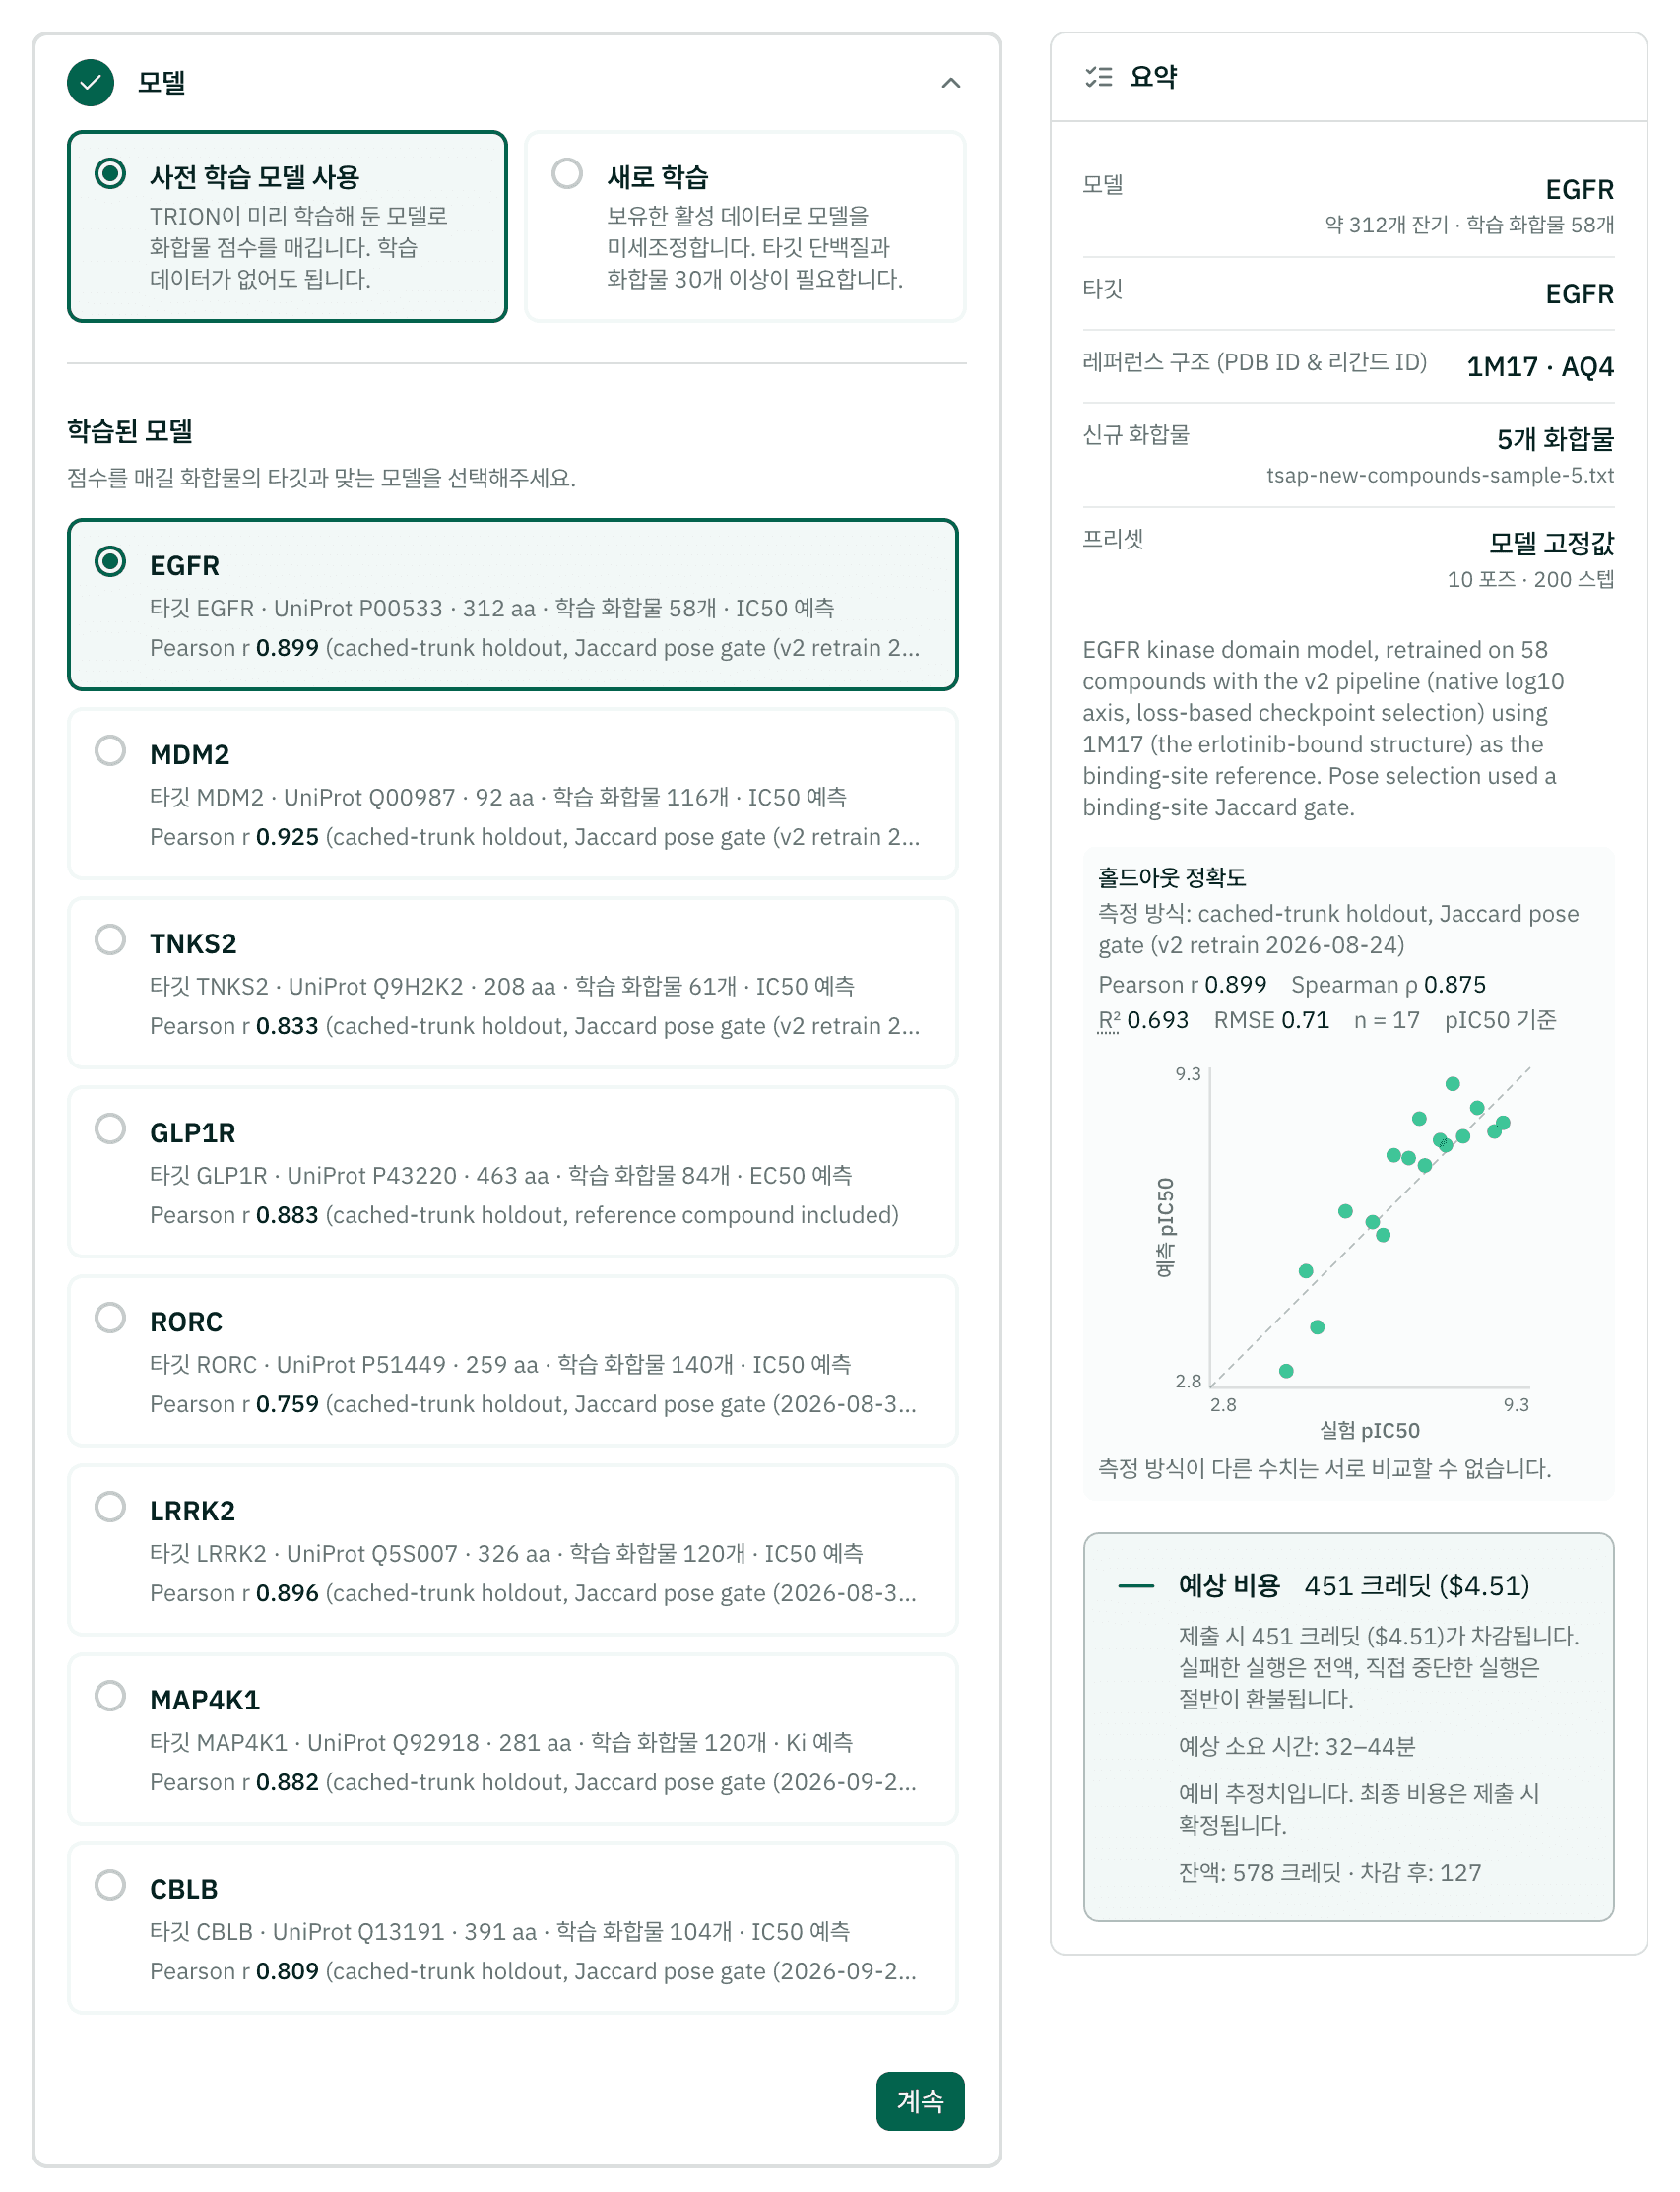
모델 단계에서 사전 학습 모델 사용을 그대로 두고 EGFR 카드를 고릅니다. 카드에 기준 구조, 학습 화합물 수, 검증 화합물에서의 정확도가 나옵니다.
화합물 넣기
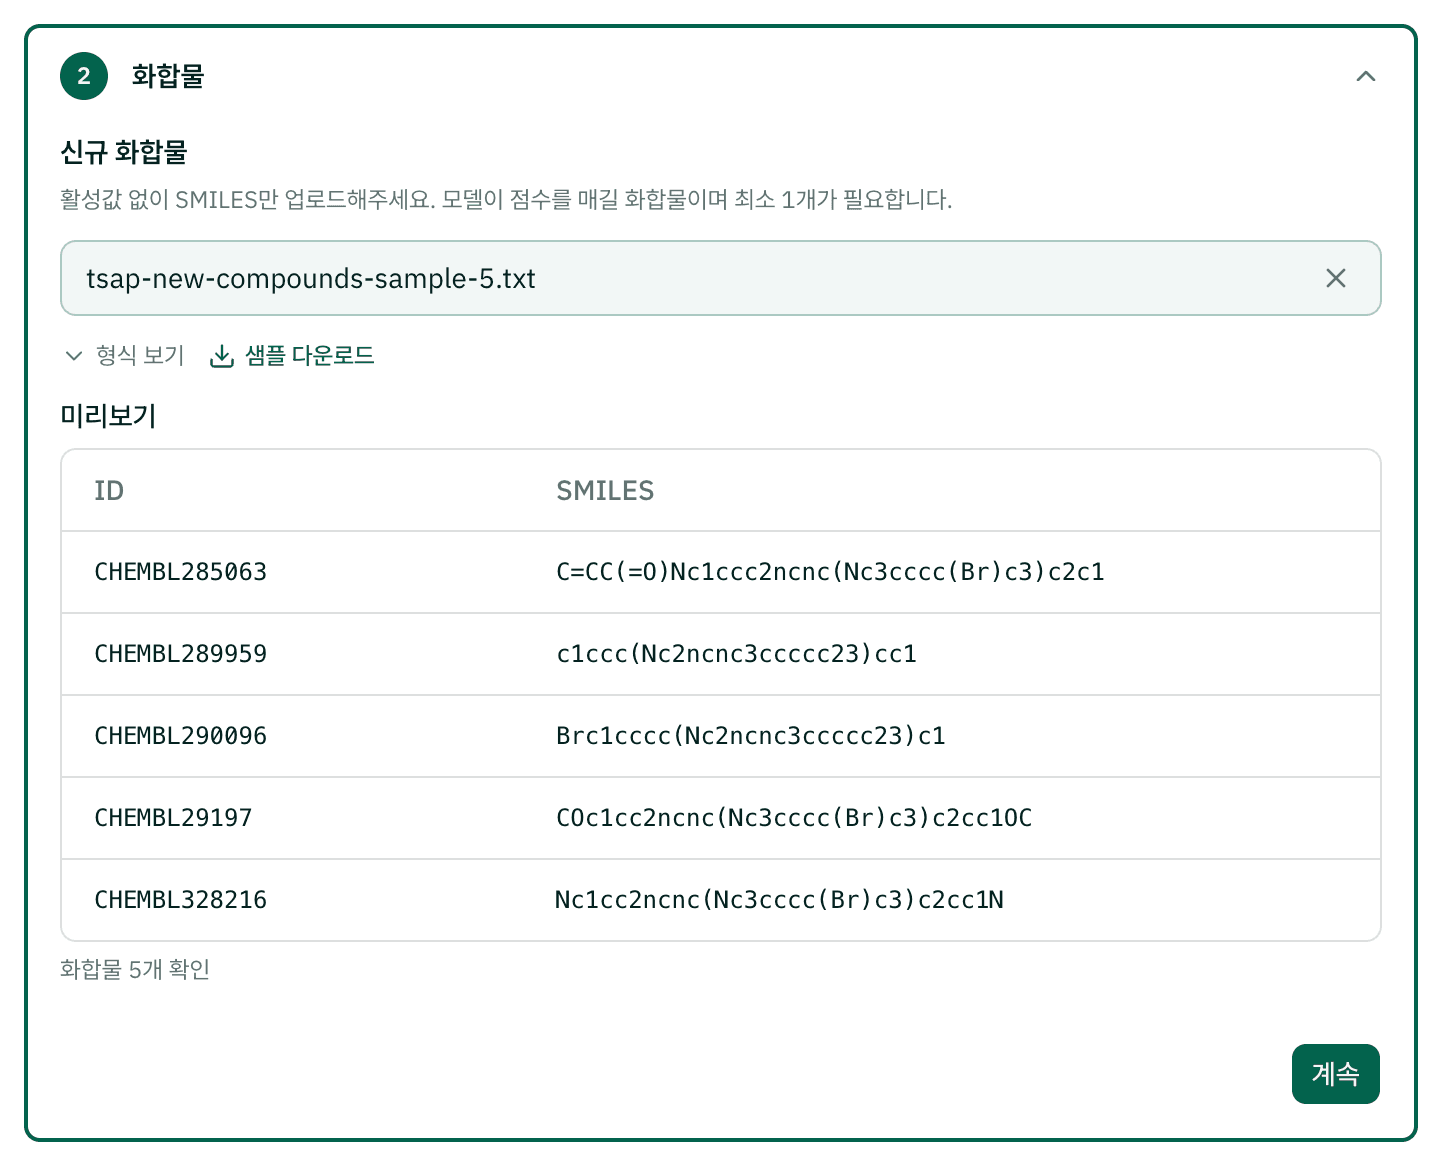
화합물 단계에서 한 줄에 SMILES 하나(앞에 ID와 탭을 붙여도 됨)인 파일을 올립니다. 예시는 단계 안에 링크된 EGFR 샘플 파일에서 5개를 씁니다. 화합물마다 GPU 시간이 늘어납니다.
견적 확인하고 제출
고급 설정은 모델이 정합니다. 프로젝트 설정에서 이름을 정하고 견적 크레딧과 시간을 확인한 뒤 제출합니다.
예측 읽기
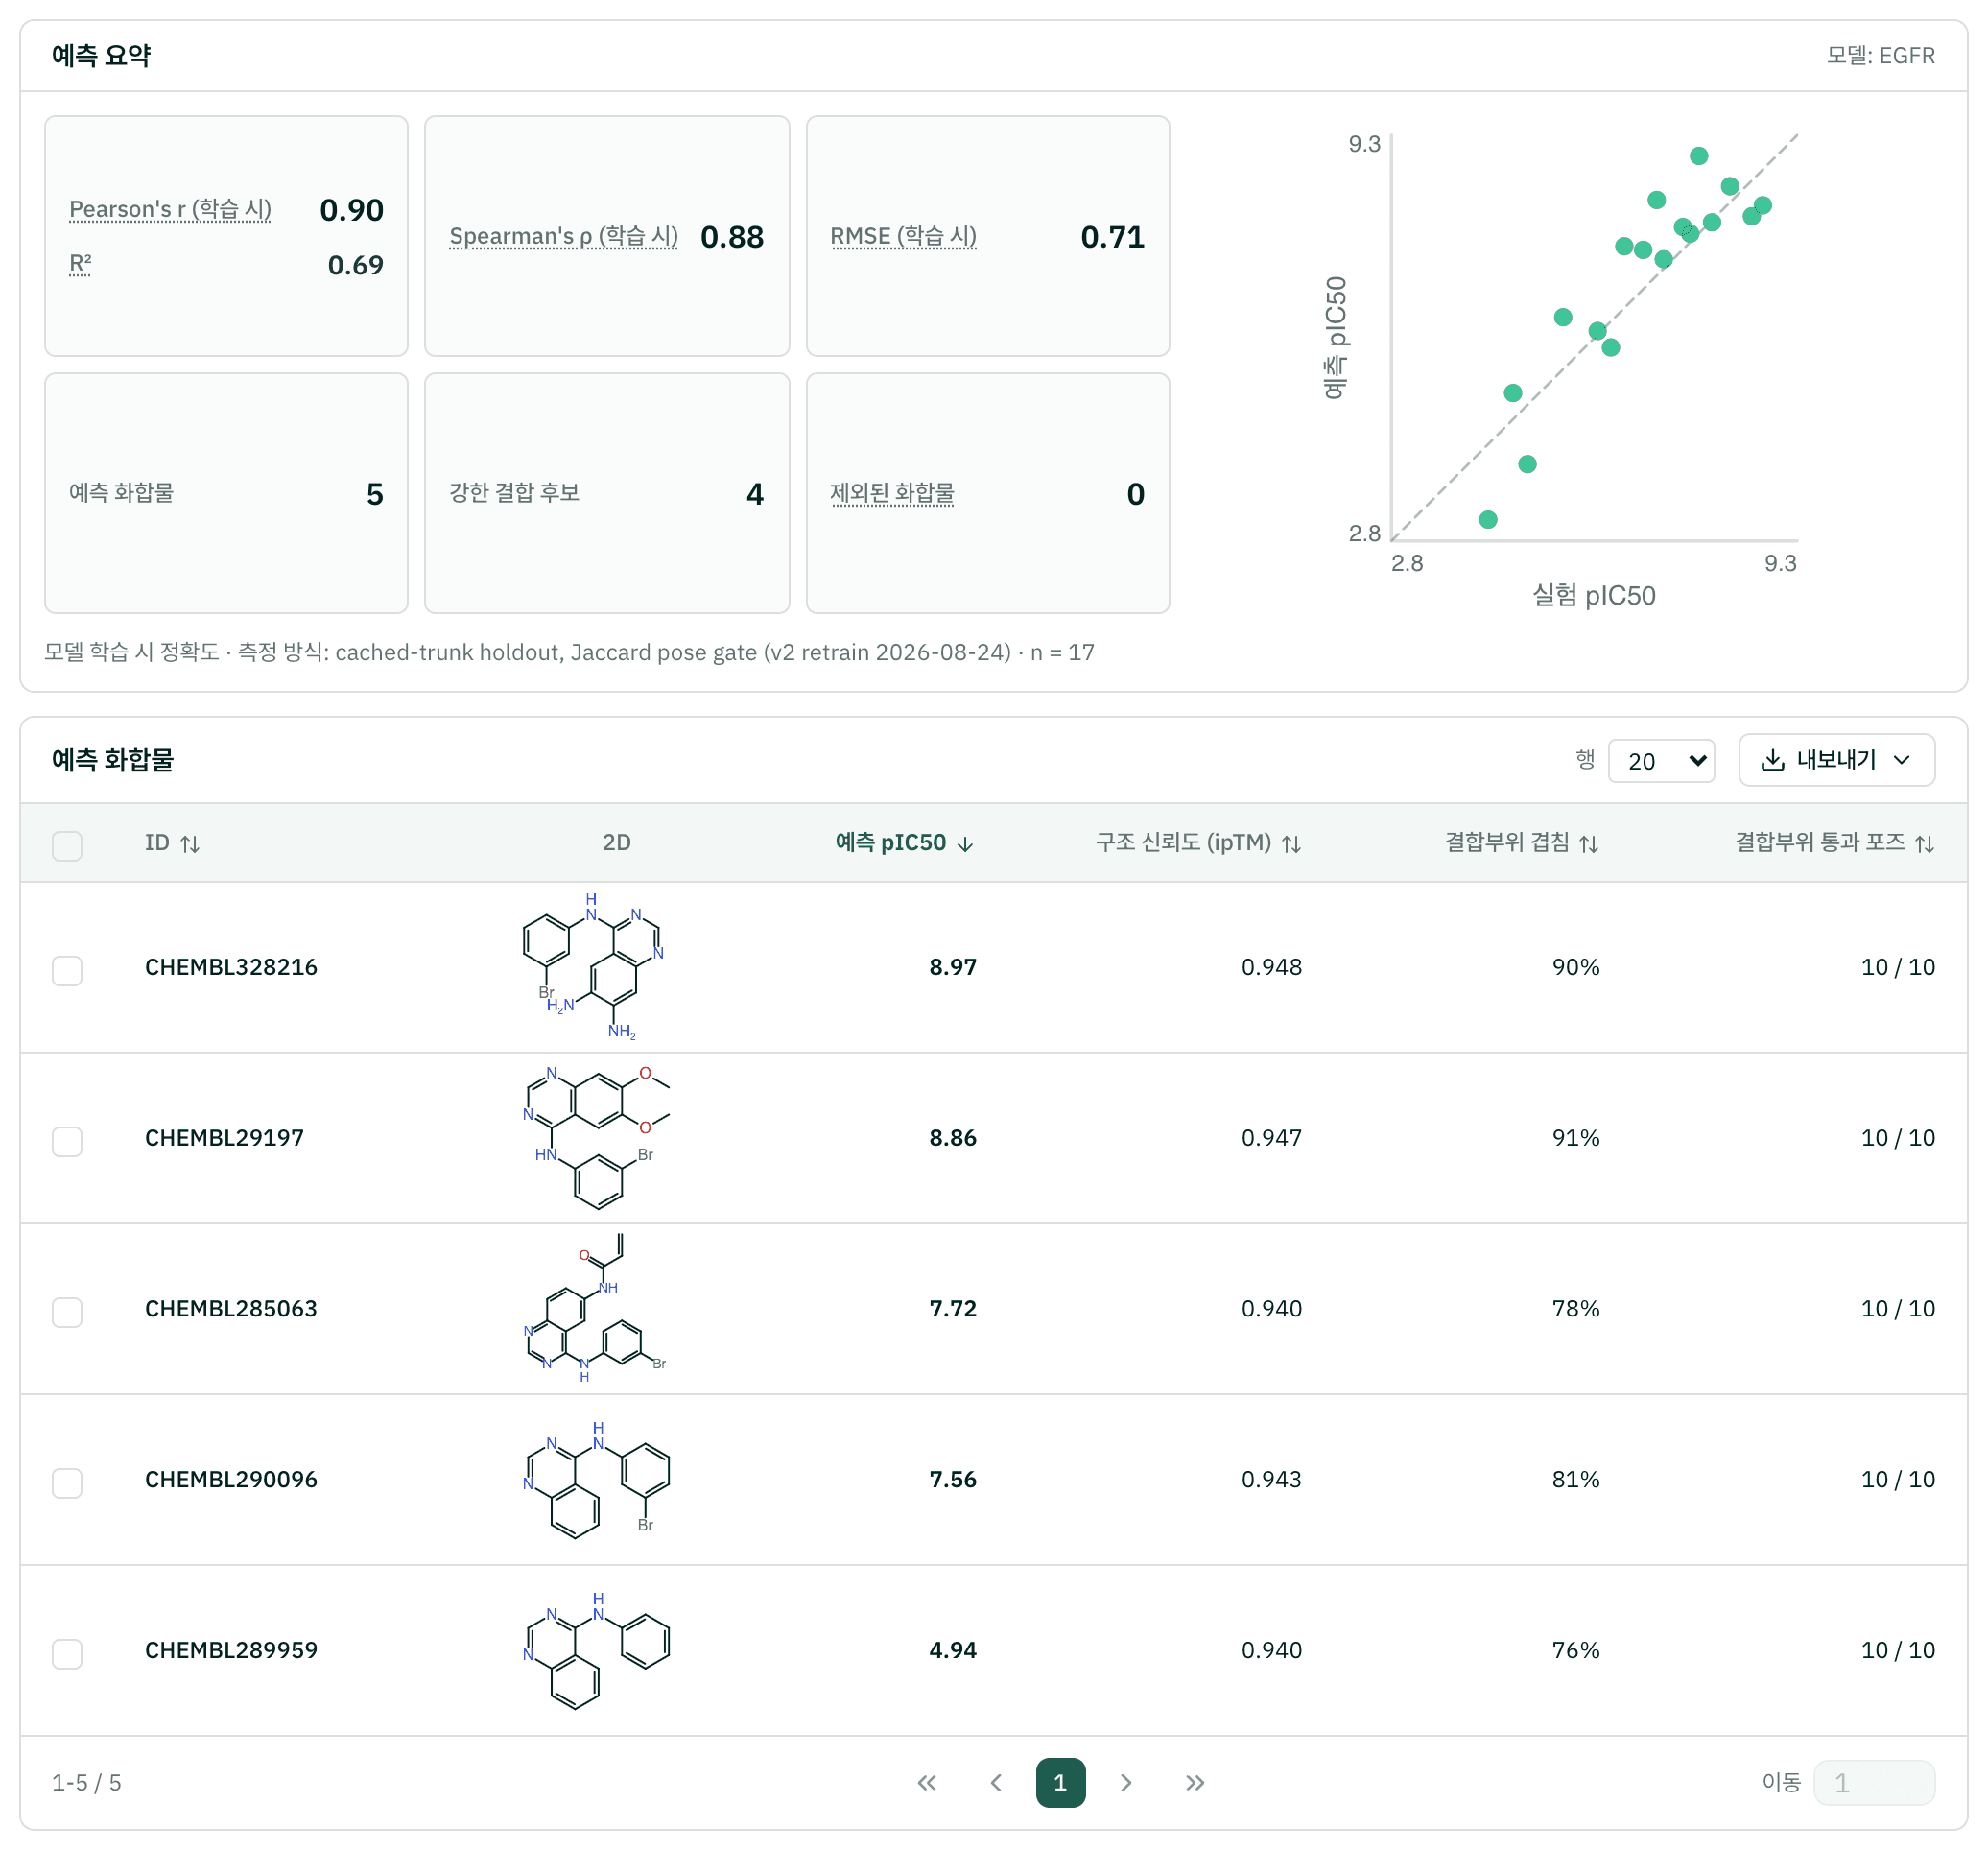
프로젝트를 열어 예측 활성으로 정렬하고, 화합물마다 구조 신뢰도와 결합 부위 겹침을 확인한 뒤 화합물을 열어 포즈를 봅니다.
결과 읽는 법
| 값 | 뜻 | 읽는 법 |
|---|---|---|
| Pred pIC50(또는 pKi, pKd, pEC50, pActivity) | 내 데이터의 p 척도로 예측한 활성 | 높을수록 활성이 큽니다. 1 차이가 10배입니다. 7.0 이상은 강한 결합체로 셉니다 |
| 구조 신뢰도(ipTM) | 예측 복합체에 대한 Boltz-2의 신뢰도(0–1) | 낮으면 포즈와 예측 모두 불안정합니다 |
| 결합 부위 겹침(Jaccard) 또는 기준 RMSD | 포즈가 기준 리간드 자리와 얼마나 맞는지 | 포즈가 결합 부위에 닿지 못한 화합물은 제외하고 이유를 함께 보여 드립니다 |
| Pearson r, R², Spearman ρ, RMSE | 검증 화합물에서 잰 모델 정확도 | 학습 잡은 내 모델의 값을, 사전 학습 잡은 그 모델을 학습할 때 잰 값을 보여 줍니다(내 화합물에서 잰 값이 아닙니다) |
| 사전 학습 대비 | 미세 조정 전 Boltz-2보다 나아진 정도 | 미세 조정이 도움이 됐는지 보여 줍니다 |
검증 화합물이 8개 미만이면 정확도 값에 신뢰하기 어렵다는 표시가 붙습니다.
예시 결과: EGFR
실제로 돌린 잡을 읽기 전용으로 보여 드립니다. 로그인하면 같은 설정으로 바로 실행할 수 있습니다.
| 화합물 | Pred pIC50 | ipTM | Jaccard |
|---|---|---|---|
| CHEMBL328216 | 8.97 | 0.948 | 0.91 |
| CHEMBL29197 | 8.86 | 0.947 | 0.91 |
| CHEMBL285063 | 7.73 | 0.940 | 0.78 |
| CHEMBL290096 | 7.56 | 0.943 | 0.81 |
| CHEMBL289959 | 4.94 | 0.940 | 0.76 |
비용과 시간
가격은 잡에 필요한 GPU 시간을 따릅니다. 화합물 수, 단백질 길이, 샘플링 단계 수가 영향을 주고, 직접 학습하면 학습 단계가 더해집니다. 사전 학습 모델은 예측 비용만 냅니다. 위저드가 서버 견적을 보여 드리고, 제출할 때 그 견적만큼만 차감합니다. 최소 금액은 100 cr(1 cr은 $0.01)입니다.
| 프리셋 | 포즈, 단계 | 위저드의 대략적 안내 |
|---|---|---|
| Quick | 5, 100 | 약 30분 |
| Standard | 10, 200 | 약 1시간 |
| High Accuracy | 20, 200 | 약 2.5시간 |
위 EGFR 예시(화합물 5개)는 제출부터 결과까지 약 38분, 451 cr이 들었습니다. 5시간 제한을 분명히 넘을 잡은 제출 전에 막습니다.
잡이 실패하거나, 결합 부위 확인 뒤 남은 화합물이 너무 적거나, 미세 조정이 사전 학습 모델보다 나아지지 않으면 크레딧을 모두 돌려 드립니다. 직접 중단하면 절반을 돌려 드립니다.
인용
이 워크플로우로 얻은 결과를 보고서나 논문에 쓸 때는 아래 방법론을 인용해 주세요.
- Passaro S, Corso G, Wohlwend J, et al.. Boltz-2: Towards accurate and efficient binding affinity prediction. bioRxiv (2025). doi:10.1101/2025.06.14.659707TSAP가 미세 조정하는 구조·친화도 모델
- RDKit contributors. RDKit: Open-source cheminformatics. Zenodo (2026). doi:10.5281/zenodo.591637SMILES 해석과 검사
- Stamos J, Sliwkowski MX, Eigenbrot C. Structure of the epidermal growth factor receptor kinase domain alone and in complex with a 4-anilinoquinazoline inhibitor. J Biol Chem 277, 46265-46272 (2002). doi:10.1074/jbc.M207135200EGFR 모델의 기준 구조(PDB 1M17)